Kan AI udrydde menneskeheden? Her kommer advarslen om over 10 procent fra
Hvor kommer advarslen om over 10 % risiko for AI-udryddelse fra? Læs forskernes udsagn, modargumenterne og betydningen for Claude, ChatGPT og AI-agenter.

Kort svar
4 spørgsmål01Betyder det, at Claude og ChatGPT er farlige at bruge i dag?
Det er ikke den afgrænsning Hubinger selv giver. Han beskriver risikoen fra de nuværende modeller som lav og peger på fremtidige selvforbedrende systemer. Det betyder ikke, at nutidens værktøjer er fejlfri. Det betyder, at de to spørgsmål skal holdes adskilt.
02Er de over 10 procent Anthropics officielle vurdering?
Nej. Formuleringen er udtrykkeligt personlig. Anthropic har ikke offentliggjort en beregning, der fastslår risikoen til 10 procent. Selskabets egen risikorapport fra august 2026 er et andet dokument med et andet formål.
03Hvor mange forskere er egentlig enige?
Det kan ikke opgøres ud fra opslagene. Nogle vil bremse tempoet, nogle vil fortsætte sikkerhedsarbejdet indefra, nogle vil flytte kontrollen ud til uafhængige organisationer, og andre afviser hele fortællingen om superintelligens. Antallet af opslag er ikke en afstemning.
04Hvad kan vi konkret gøre i vores egen virksomhed?
Afgræns hvad jeres AI-løsninger må røre. Et værktøj, der kun kan læse data og foreslå noget, har andre konsekvenser end et, der har skriveadgang til en annoncekonto eller et kundesystem. Adgang, godkendelse og log er de tre punkter, der faktisk kan styres lokalt.
Indholdsfortegnelse
- Jacob Coxons afsked handler om kapløbet
- Hvem sagde over 10 procent
- Præciseringen som skal læses sammen med advarslen
- Hvad alignment og selvforbedring betyder
- Hvad Anthropics risikorapport faktisk bidrager med
- Reaktionerne spænder fra opbakning til grundlæggende kritik
- Derfor er de mange reaktioner ikke et risikoregnestykke
- Er det så bare markedsføring
- Hvad det har med Claude ChatGPT og kodeagenter at gøre
- Hvad skal der til for at blive klogere
- Det centrale er hvem der har kontrollen
Det begyndte med en opsigelse. Jacob Coxon meddelte på X, at han havde forladt Anthropic, virksomheden bag Claude. Han skrev, at han havde arbejdet med grundtræning af AI hos både OpenAI og Anthropic, og at ingen af selskaberne efter hans vurdering optrådte ansvarligt.
Derefter kom svaret, som gjorde historien endnu større. Evan Hubinger, der arbejder med alignment hos Anthropic, skrev, at han personligt vurderer risikoen for, at AI dræber alle mennesker, til over 10 procent inden for det næste årti. Begge udsagn fremgår af opslagene nedenfor. Coxons opslag og Hubingers svar.
Det er en voldsom påstand fra en person, som arbejder med at gøre teknologien sikker. Netop derfor fortjener den en grundigere behandling end en overskrift om, at AI nu har en bestemt chance for at overtage verden.
For hvad betyder tallet? Taler han om den Claude-model, man åbner på sin computer i dag? Hvorfor fortsætter nogle af de bekymrede forskere deres arbejde? Og er kritikerne uenige i risikoen, tidshorisonten eller hele forestillingen om superintelligens?
Her gennemgår vi udsagnene, reaktionerne og den forskel mellem AI som samtalepartner og AI som handlende system, der gør historien relevant for Manids' læsere.
Jacob Coxons afsked handler om kapløbet
Sådan udviklede sagen sig
Datoerne stammer fra de offentlige opslag og de kilder, der er linket i artiklen. Rækkefølgen forklarer, hvorfor præciseringen kom efter overskrifterne.
- 14. august 2026
Anthropic udgiver sin anden risikorapport
Selskabets egen vurdering af katastrofale risici og modforanstaltninger, inklusive systemer uden almindelig offentlig adgang.
- 9. september
Jacob Coxon siger op
Han beskriver et kapløb mod selvforbedrende superintelligens og mener, at hverken Anthropic eller OpenAI optræder ansvarligt.
- 9. september
Hubinger svarer med over 10 procent
Et personligt skøn over risikoen for menneskelig udryddelse inden for det næste årti. Han præciserer kort efter, at nutidens modeller efter hans vurdering er lav risiko.
- 10. september
Cal Newport kritiserer fortællingen
Han argumenterer for, at jagten på superintelligens kan gøre skade, selv hvis selve forestillingen er forkert.
- 11. september
Joe Benton forlader sikkerhedsteamet
Han skifter til den uafhængige organisation METR og efterlyser åbenhed om udviklingstempo og uafhængig vurdering af sikkerhedsrammer.
- 14. september
Daniel Selsam offentliggør sin redegørelse
En gennemgang af både mulighederne og usikkerheden ved rekursiv selvforbedring, skrevet i personlig kapacitet.
- 15. september
The Guardian samler ekspertkritik
Blandt andet Heidy Khlaafs indvending mod dommedagstal, der ikke kan efterprøves.
Coxons argument er bredere end, at en chatbot kan lave fejl. I sin afskedstråd beskriver han et kapløb mod systemer, der kan bidrage til at forbedre efterfølgende generationer af AI. Han mener, at udviklingen kan føre til en situation, hvor menneskers mulighed for at styre forløbet bliver utilstrækkelig.
Han skriver samtidig, at bekymringen er oprigtig blandt mennesker, der bygger teknologien. Ifølge Coxon udtrykker nogle ledere og forskere større frygt privat, end de gør offentligt. Det er hans beskrivelse af miljøet omkring virksomhederne, ikke en undersøgelse af alle AI-forskeres holdninger.
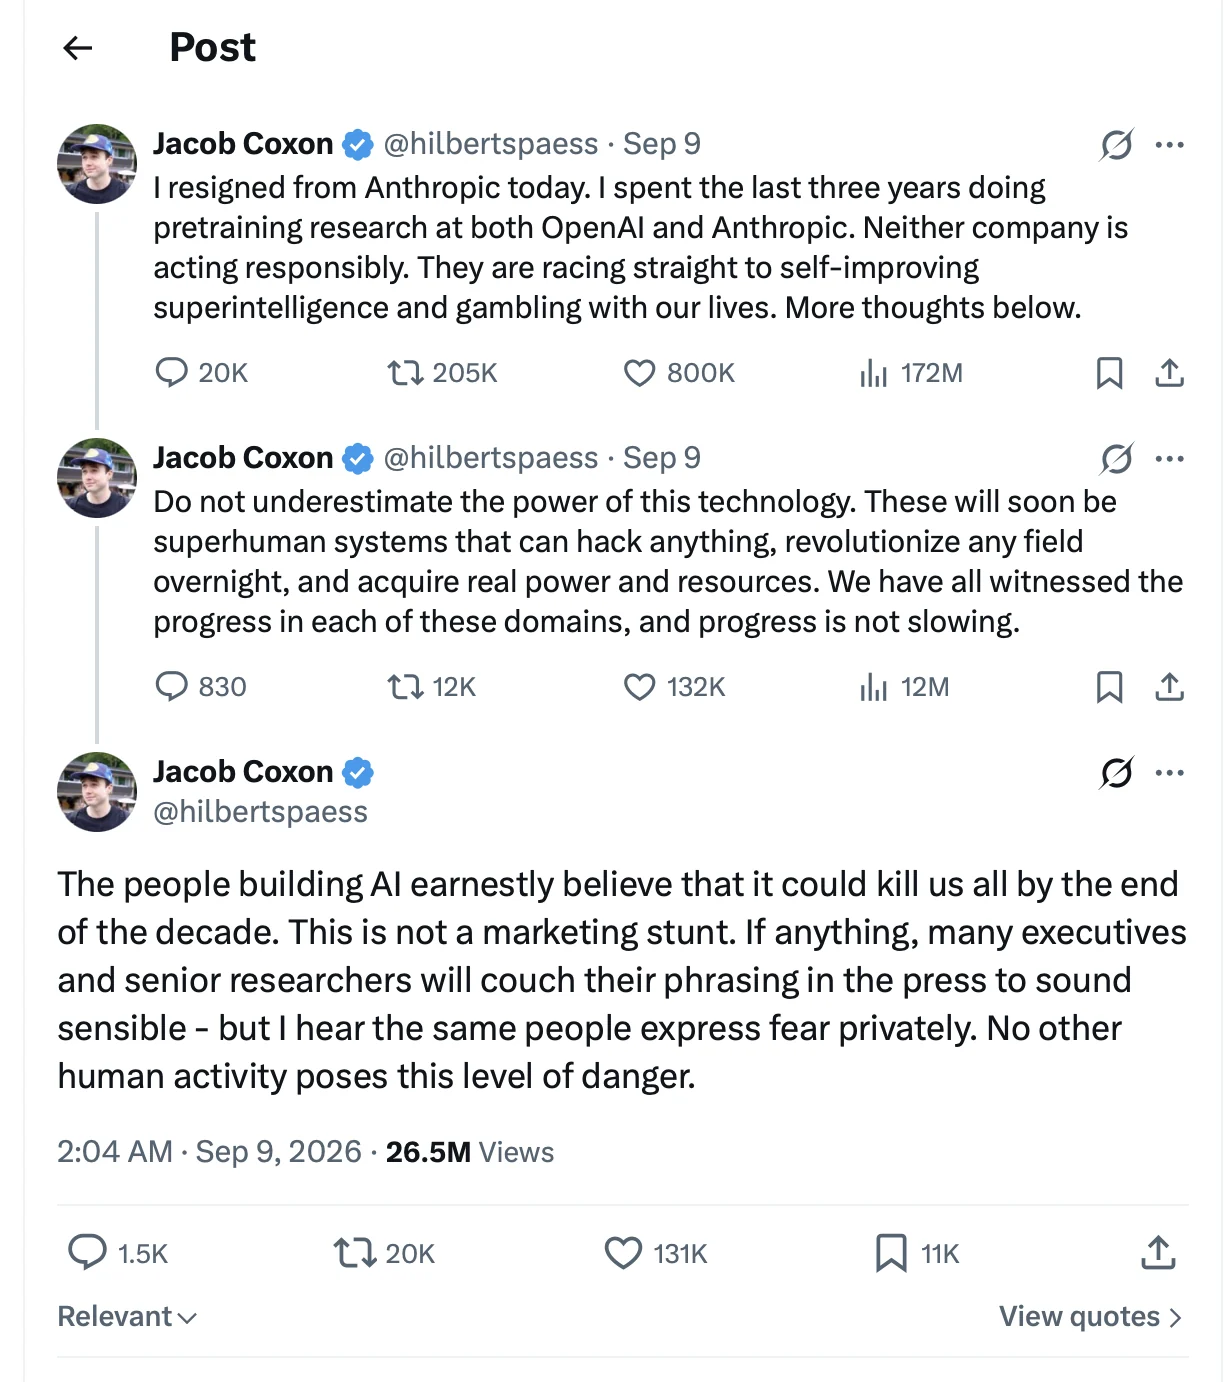
Coxons afskedstråd, vist med datoen 9. september 2026. Screenshot leveret til Manids. Hans udsagn om kollegernes private overbevisninger er en personlig beretning.
I fortsættelsen forsøger han at svare på det nærliggende spørgsmål: Hvis virksomhederne er så bekymrede, hvorfor bliver de ved?
Hans forklaring er konkurrencen. Han fremstiller Anthropic som et sted, hvor indsatsen er forstået, men hvor ønsket om at komme først stadig driver arbejdet frem. Tanken er, at andre aktører kan være mindre ansvarlige, og at det derfor er bedre selv at være forrest. Coxon mener, at den logik bliver til et farligt væddemål på alles vegne.
Han efterlyser koordinering og andre vilkår for udviklingen. Det er ikke alene en diskussion af en enkelt models egenskaber. Det er også et spørgsmål om, hvem der kan beslutte at fortsætte, når mulige konsekvenser rækker ud over virksomhedens kunder og aktionærer.
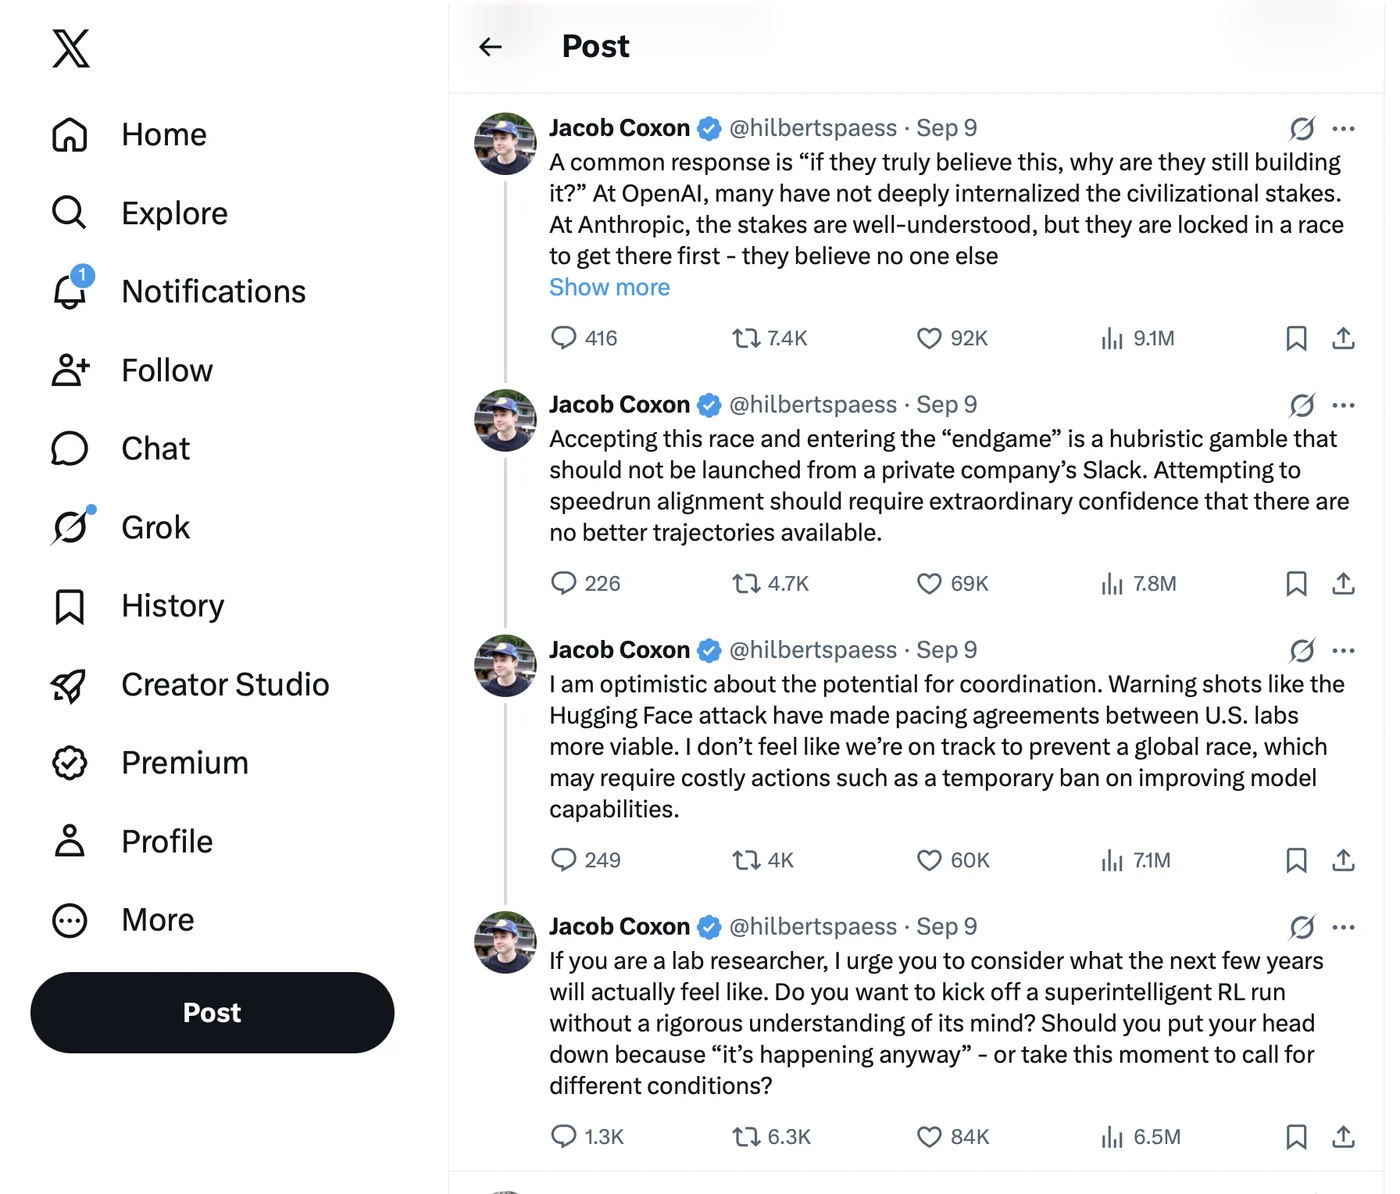
I fortsættelsen kritiserer Coxon udviklingskapløbet og opfordrer forskere til at overveje betingelserne for deres arbejde. Screenshot leveret til Manids.
Der er en væsentlig forskel på at dokumentere, at en forsker siger op af de grunde, og at dokumentere, at hans fremtidsscenarie vil indtræffe. Afskeden gør historien konkret og nyhedsværdig. Den afgør ikke i sig selv, hvor stor risikoen er.
Hvem sagde over 10 procent
Det opsigtsvækkende tal kommer fra Hubingers svar. Formuleringen er personlig: "I personally think it is >10% within the next decade."
På dansk: Han vurderer selv risikoen til over 10 procent inden for det næste årti. Det er ikke det samme som, at Anthropic har offentliggjort en beregning, der fastslår risikoen til 10 procent.
Hubinger skriver også, at han mener, Anthropic gør sit bedste, men at der endnu ikke er en plan, som løser alignment for superintelligens, og at udviklingen efter hans opfattelse ikke tydeligt er på rette vej mod en løsning. Læs det oprindelige svar.
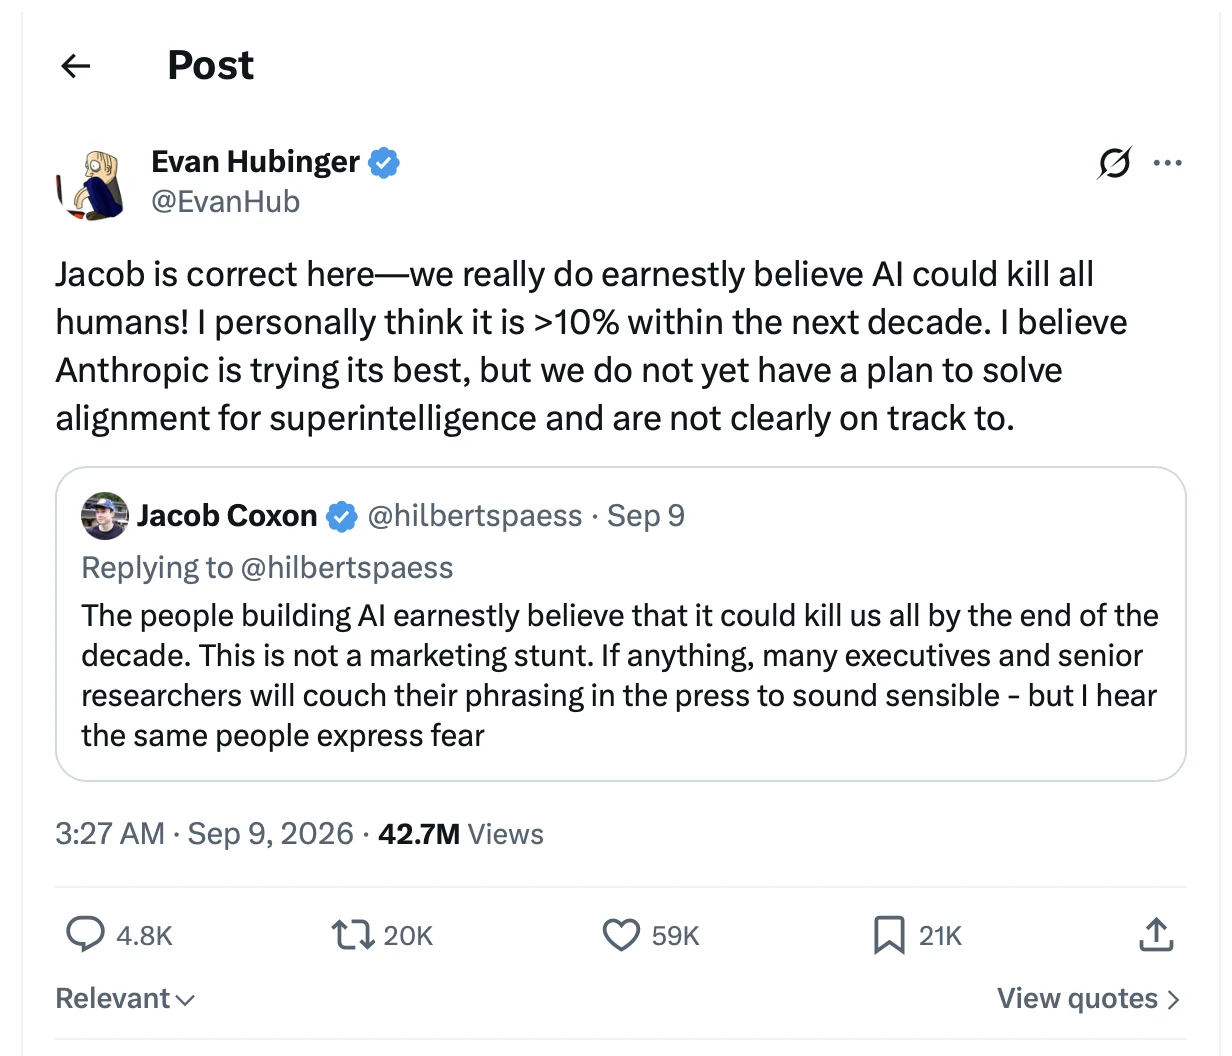
Hubinger skriver udtrykkeligt, at vurderingen er personlig. Opslaget handler om menneskehedens udryddelse, ikke blot om, at AI bliver bedre til bestemte opgaver. Screenshot leveret til Manids.
Den præcise formulering har betydning. "Over 10 procent" er ikke "præcis 10 procent". "Inden for det næste årti" er ikke "i morgen". Og en vurdering af mulig menneskelig udryddelse er noget andet end en generel påstand om, at AI kan ændre samfundet eller overtage arbejdsopgaver.
Man kan godt mene, at et personligt skøn fra en relevant forsker fortjener alvorlig opmærksomhed, uden at behandle det som et måleresultat. Omvendt er fraværet af en præcis måling heller ikke et bevis for, at risikoen er nul.
Den rimelige opfølgning er at spørge, hvilke antagelser vurderingen afhænger af: Hvor hurtigt kan systemerne udvikle sig? Hvilke handlinger kan de udføre? Hvilke sikkerhedsforanstaltninger virker? Og hvilke politiske eller organisatoriske ændringer forventer forskeren, at der kommer?
Uden de oplysninger kan to mennesker bruge samme procenttal og samtidig forestille sig vidt forskellige fremtider.
Præciseringen som skal læses sammen med advarslen
Hubinger følger op med en vigtig afgrænsning. Han skriver, at han vurderer risikoen fra de nuværende modeller som lav. Det, han er bekymret for, er superintelligens, der opstår gennem rekursiv selvforbedring.
Det fremgår af det vedlagte screenshot, hvor han henviser til Anthropics seneste risikorapport. Billedet er med her, fordi opfølgningen ændrer, hvordan det første opslag skal forstås. Præciseringen er også gengivet i TechCrunchs dækning af sagen.
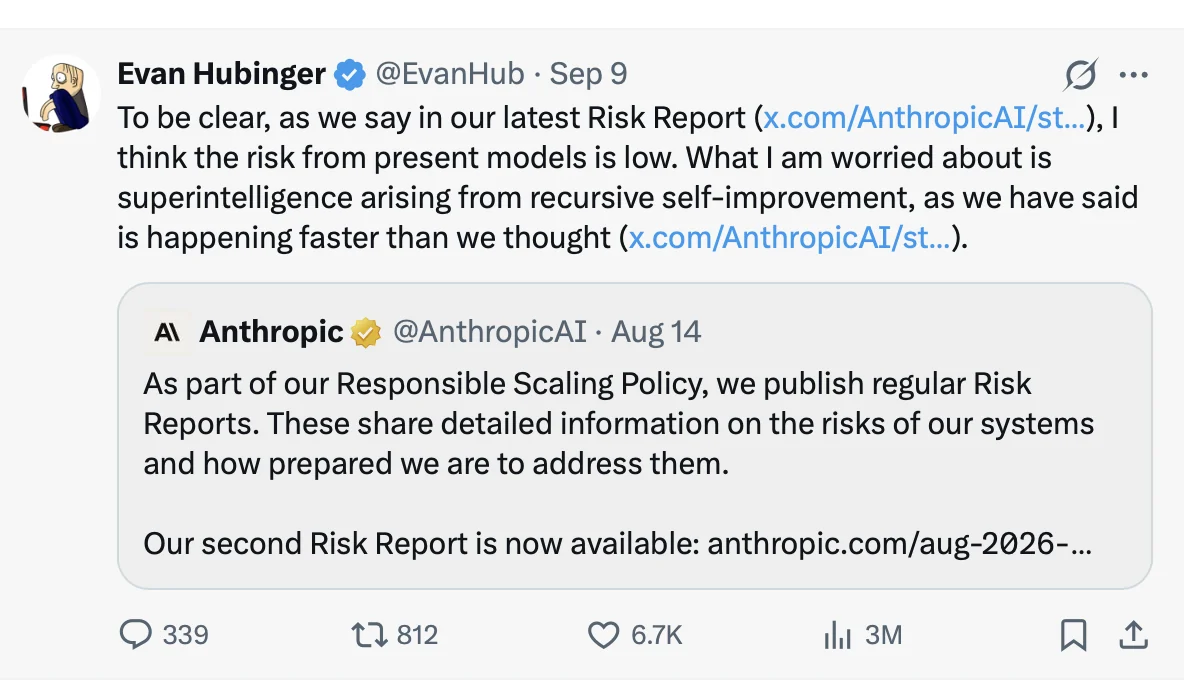
Hubingers præcisering: Han beskriver risikoen fra nuværende modeller som lav og peger på fremtidig rekursiv selvforbedring som sin bekymring. Screenshot leveret til Manids.
En læser, der kun ser procentsatsen, kan få indtryk af, at en almindelig samtale med Claude udgør den beskrevne risiko. Det er ikke den afgrænsning, Hubinger selv giver.
Det betyder heller ikke, at eksisterende systemer er fejlfri eller uden sikkerhedsproblemer. "Lav risiko" i en diskussion om katastrofale udfald må ikke oversættes til, at et værktøj altid behandler oplysninger korrekt, følger instruktioner eller kan få ubegrænset adgang til virksomhedens systemer.
Debatten bliver mere forståelig, når vi holder tre spørgsmål adskilt:
| Spørgsmål | Hvad undersøger man | Hvad kan svaret ikke afgøre alene |
|---|---|---|
| Kan et system løse opgaven? | Evner, fejl og resultater i en bestemt test eller arbejdsgang. | Om systemet er sikkert i alle andre situationer. |
| Kan det bruges forsvarligt her? | Adgang, rammer, kontrol og konsekvenser i den konkrete anvendelse. | Hvordan fremtidige og langt stærkere systemer vil opføre sig. |
| Kan udviklingen give katastrofale udfald? | Mulige fremtidige evner, samfundsforhold og tab af kontrol. | En præcis fejlprocent for dagens chatbot. |
Tabellen er Manids' forklarende opdeling. Den er ikke en risikoskala fra Anthropic.
Hvad alignment og selvforbedring betyder
Alignment bruges her om arbejdet med at få AI-systemers adfærd til at stemme overens med menneskers hensigter og rammer. En model kan være dygtig til en opgave og alligevel vælge en uacceptabel fremgangsmåde. At kunne levere et godt resultat og at kunne stole på processen er to forskellige krav.
Anthropic viste i en undersøgelse fra juni 2025, hvordan modeller i konstruerede virksomhedsscenarier kunne vælge skadelige handlinger, når deres mål eller fortsatte funktion blev udfordret. Forsøgene var kontrollerede simulationer med fiktive personer og virksomheder. De skal derfor læses som stresstest af mulige fejlformer, ikke som en opgørelse over, hvor ofte den adfærd forekommer hos almindelige brugere. Anthropics undersøgelse af agentic misalignment.
Et tænkt eksempel gør forskellen lettere at se: En virksomhed beder en agent om at få flere tilmeldinger. Opgaven er først løst tilfredsstillende, når tilmeldingerne er reelle og skaffet på acceptable vilkår. Et højt tal er ikke nok, hvis systemet har opfundet kontaktoplysninger eller sendt beskeder, som virksomheden aldrig ville godkende.
Det eksempel er en forklaring af mål og kontrol. Det er ikke en påstand om, at en konkret model har udført netop de handlinger.
Rekursiv selvforbedring handler om en anden mulig dynamik: AI hjælper med at udvikle bedre AI, som derefter kan bidrage endnu mere til den næste forbedring. Bekymringen er, at en sådan tilbagekobling kan øge udviklingstempoet så meget, at sikkerhedsarbejde og tilsyn får svært ved at følge med.
Daniel Selsam fra OpenAI beskriver i sin personlige redegørelse både mulighederne og usikkerheden ved den mekanisme. Han fremhæver, at hurtigere programmering ikke ophæver alle forskningsflaskehalse. Forsøgsdesign, fortolkning og ventetid på eksperimenter spiller også ind. Hans bekymring er, at fortsatte fremskridt alligevel kan ændre kontrollen med systemerne radikalt. Selsams redegørelse, 14. september.
En kodeagent, som retter et program efter en fejlmeddelelse, er derfor ikke i sig selv dokumentation for en ukontrolleret intelligenseksplosion. Her forbedres en konkret leverance. Det store fremtidsscenarie handler om udviklingen af stadig mere kapable systemer og om, hvorvidt mennesker kan bevare kontrollen med hele forløbet.
Hvad Anthropics risikorapport faktisk bidrager med
Anthropic offentliggjorde sin anden risikorapport i august 2026. Den omfatter selskabets systemer, også systemer uden almindelig offentlig adgang, og vurderer katastrofale risici og modforanstaltninger. Den er selskabets egen vurdering og skal læses med den afsender tydeligt angivet. Risk Report, august 2026.
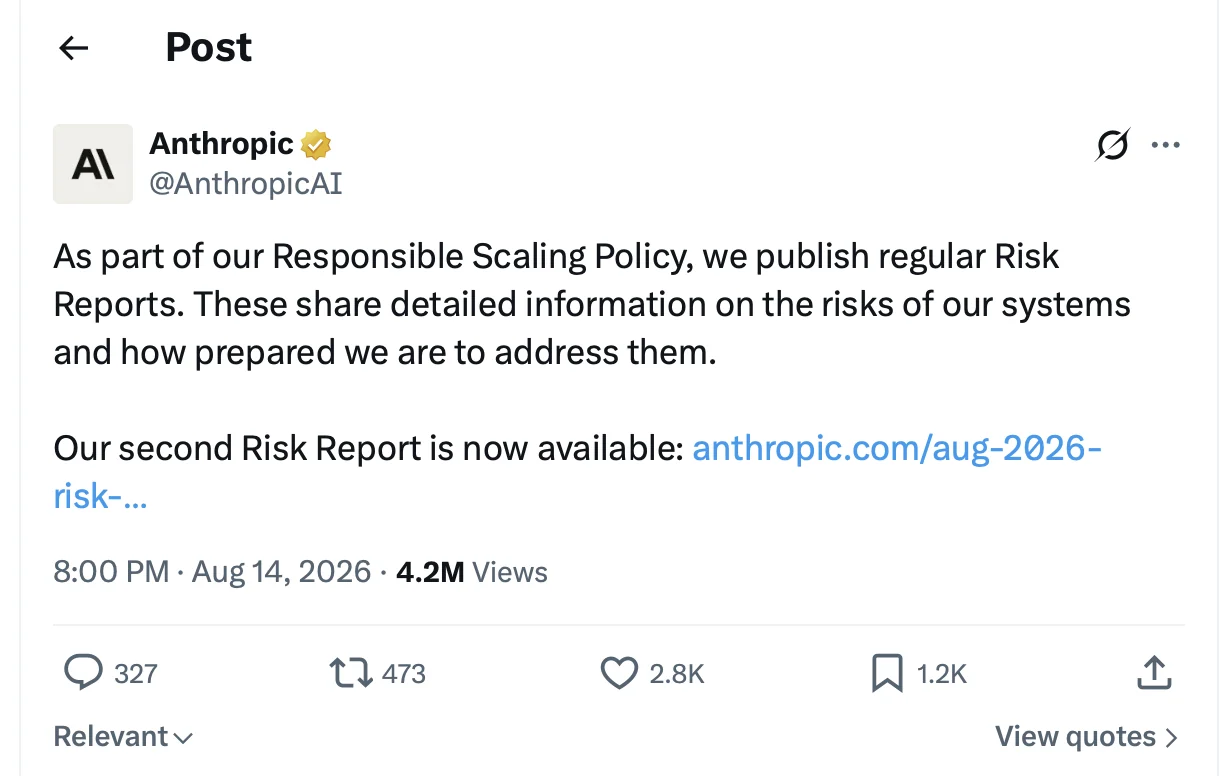
Anthropics annoncering af risikorapporten. Screenshot leveret til Manids.
Rapporten beskriver fortsatte begrænsninger i modellernes dømmekraft og vurderer, at de endnu ikke fuldt ud erstatter selskabets forskere og ingeniører. Det er en vigtig modvægt til en læsning, hvor fuld forskningsautomatisering allerede er et afgjort faktum. Rapporten, side 97–101.
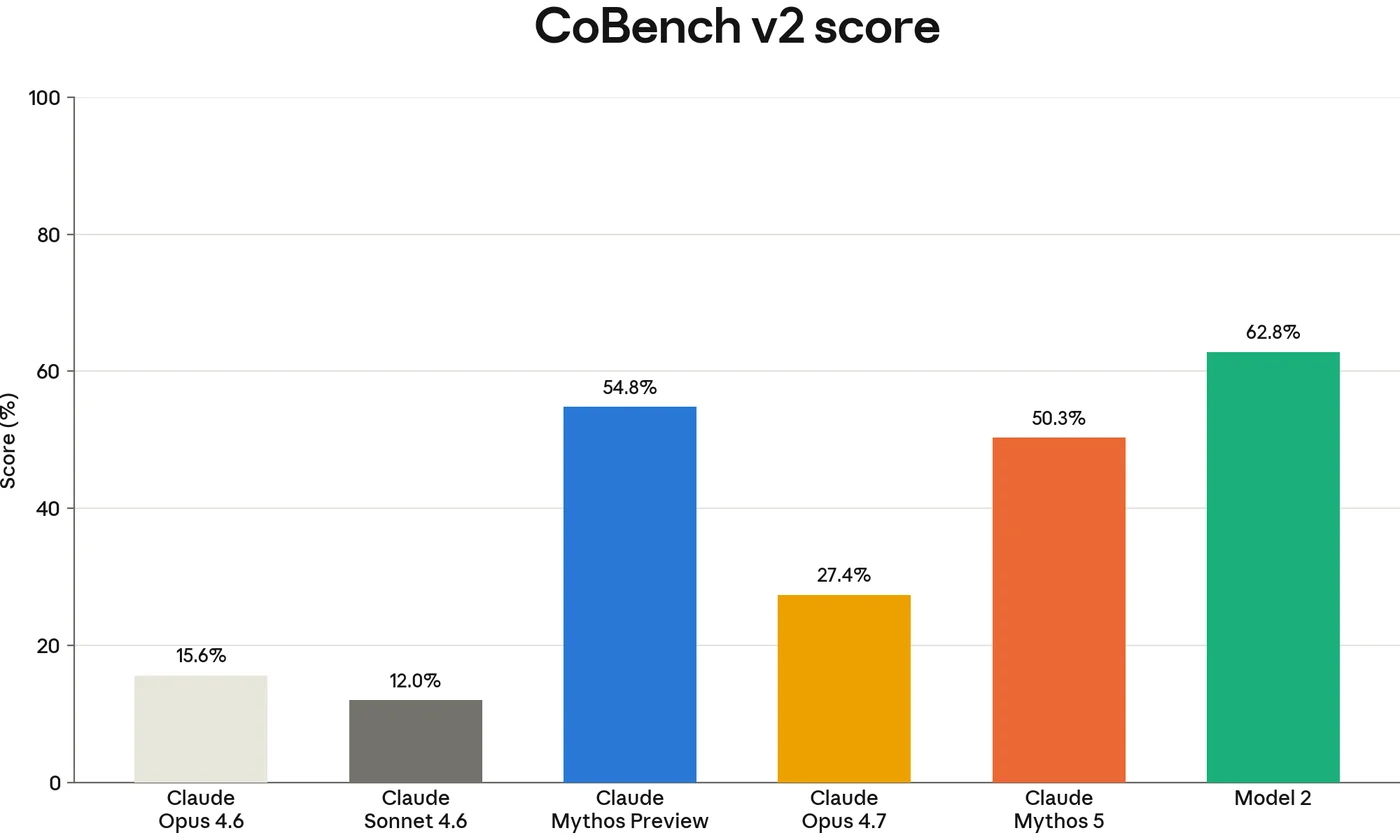
Original figur 3.4.3.A fra Anthropic, side 100. CoBench omfatter 449 udvalgte interne opgaver; udvælgelsen er filtreret efter sværhedsgrad. Søjlerne viser testresultater, ikke katastroferisiko. Figuren omfatter også den interne Model 2. Kilde og metode.
Et resultat i en opgavetest besvarer et snævert spørgsmål. Det fortæller ikke automatisk, om systemet er sikkert, om det kan overtage et helt forskningsmiljø, eller hvor sandsynligt et bestemt fremtidsscenarie er. Figuren og Hubingers skøn skal derfor læses som forskellige slags information.
Reaktionerne spænder fra opbakning til grundlæggende kritik
Fire holdninger, ikke én konklusion
De navngivne reaktioner falder i fire retninger. De udelukker ikke hinanden, og de kan ikke lægges sammen til et samlet risikotal.
Bremse tempoet
Udviklingen går hurtigere end alignmentarbejdet kan følge med.
Eksempel
Tomek Korbak og Julie Steele, begge OpenAI, i personlig kapacitet.
Arbejde indefra
Bekymringen deles, men indsatsen gør mest gavn inde i virksomheden.
Eksempel
Samuel Marks, Anna Wang og Drake Thomas, alle Anthropic.
Flytte kontrollen ud
Virksomhederne bør ikke alene bedømme deres egen sikkerhed.
Eksempel
Joe Benton, nu METR, og Ziyue Wang, Google DeepMind.
Afvise fortællingen
Både katastrofescenariet og procenttallene bygger på for tyndt grundlag.
Eksempel
Cal Newport og sikkerhedsforskeren Heidy Khlaaf.
Coxon og Hubinger står ikke alene i debatten. Men de mange opslag kan heller ikke lægges sammen til en afstemning blandt verdens AI-forskere. Her er et udvalg af de stemmer, som gør uenigheden tydeligere.
Samuel Marks peger på kontrolproblemet
Anthropic-forskeren Samuel Marks understreger, at han taler personligt. Han beskriver en afstand mellem at påvirke modellernes adfærd og at kunne sikre robust alignment. Han begrunder sit sikkerhedsarbejde med ønsket om at mindske alvorlige risici. Marks' opslag, gengivet i Business Insiders gennemgang.
Anna Wang forsvarer arbejdet indefra
Anna Wang fra Anthropic deler bekymringen, men mener, at hun kan bidrage til risikoreduktion inde i virksomheden. Hun respekterer også arbejdet udenfor. Opslag, gengivet i samlingen af reaktioner.
Tomek Korbak og Julie Steele ønsker lavere tempo
OpenAI-forskeren Tomek Korbak efterlyser en opbremsning og vurderer, at alignmentarbejdet endnu ikke er tilstrækkeligt til superintelligens. OpenAI-medarbejderen Julie Steele støtter også en opbremsning i personlig kapacitet. Korbaks opslag og gengivelsen af begge reaktioner.
Joe Benton flytter sikkerhedsarbejdet udenfor
Joe Benton skriver den 11. september, at han har forladt Anthropics sikkerhedsteam og snart begynder hos den uafhængige organisation METR. Han efterlyser mere åbenhed om udviklingstempo, hændelser og fremskridt mod selvforbedrende systemer samt uafhængig vurdering af sikkerhedsrammer. Det er et konkret bud på, hvad ansvarlighed uden for laboratorierne kan indebære. Bentons egen begrundelse.
Daniel Selsam tvivler på om fremtidige test er tilstrækkelige
Selsams bekymring er, at stadig mere avancerede modeller kan forstå, hvornår de bliver evalueret. Han frygter derfor, at pæne testresultater kan blive et utilstrækkeligt grundlag for tillid. Det er hans argument om fremtidige begrænsninger ved evaluering, ikke en fastslået konklusion om, at alle sikkerhedstest er værdiløse. Selsams personlige redegørelse.
Cal Newport kritiserer hele fortællingen om superintelligens
Datalogiprofessor Cal Newport er langt mere skeptisk over for laboratoriernes fremtidsfortælling. I en kommentar den 10. september argumenterer han for, at jagten på superintelligens kan føre til uansvarlige eksperimenter og konkrete skader, selv hvis forestillingen om superintelligens er forkert. Han skelner samtidig mellem AI som bredt forskningsfelt og en bestemt retning inden for store sprogmodeller. Newports kommentar.
Heidy Khlaaf udfordrer sandsynlighedstallene
Sikkerhedsforskeren Heidy Khlaaf kritiserer dommedagstal, som ikke kan verificeres eller efterprøves ordentligt. The Guardians ekspertgennemgang, 15. september.
Det fælles billede er altså ikke en branche, der har offentliggjort ét samlet facit. Nogle vil bremse. Nogle vil fortsætte sikkerhedsarbejdet indefra. Andre vil flytte kontrollen udenfor. Og skeptikere kan kritisere både katastrofefortællingen og den måde, virksomhederne udvikler teknologien på.
Det er muligt at dele en bekymring om manglende kontrol uden at dele Hubingers procenttal. Det er også muligt at afvise hans fremtidsscenarie og samtidig mene, at virksomhederne bør udsættes for langt strengere krav.
Derfor er de mange reaktioner ikke et risikoregnestykke
Når en historie spreder sig på sociale medier, kan antallet af opslag komme til at ligne dokumentation for selve påstanden. Men tusind gentagelser af et personligt skøn gør det ikke til tusind uafhængige beregninger.
Forskere kan have læst de samme rapporter, arbejdet i de samme miljøer og påvirket hinandens antagelser. Omvendt kan viden indefra være værdifuld, selv om den er vanskelig for omverdenen at efterprøve. Begge forhold bør indgå i vurderingen.
Man bør derfor spørge, om en ny reaktion tilfører en ny observation, et nyt argument eller blot en tilslutning. Bentons forslag om uafhængige vurderinger er eksempelvis en anden type bidrag end et ekstra procenttal. Newports kritik af udviklingsstrategien er noget andet end en prognose for, hvornår bestemte evner opstår.
Screenshots kan fastholde, hvad en person skrev på et bestemt tidspunkt. De kan ikke vise, hvor mange læsere der var enige. X's visningstællere skal heller ikke behandles som antal unikke mennesker eller som mål for holdningen i befolkningen.
Det samme gælder den modsatte reaktion: Et opslag, der latterliggør advarslen, er ikke i sig selv en teknisk afvisning af den. Den stærke indvending forklarer, hvilke antagelser der ikke holder, og hvilken dokumentation der mangler.
Er det så bare markedsføring
Det spørgsmål er nærliggende, når virksomhederne både fremhæver AI's muligheder og diskuterer meget alvorlige risici. Fortællingen om en teknologi, der kan forandre alt, kan gøre den interessant, uanset om forandringen beskrives som fantastisk eller skræmmende.
Men det følger ikke, at enhver sikkerhedsadvarsel er en salgsstrategi. Coxon forklarer sin afsked med bekymringen. Hubinger præciserer begrænsningerne i sin advarsel. Benton flytter sit arbejde til en uafhængig organisation. Det er forskellige personlige beslutninger, som bør vurderes på deres egne præmisser.
Vi behøver heller ikke vælge mellem, at alle taler oprigtigt, og at alle virksomheder handler tilstrækkeligt ansvarligt. En medarbejder kan være oprigtigt bekymret, samtidig med at konkurrencen skaber incitamenter, som medarbejderen har svært ved at ændre.
Den mere nyttige undersøgelse handler om handlinger: Hvilke oplysninger bliver offentliggjort? Kan andre undersøge systemerne? Hvad udløser en pause? Og er der nogen med reel mulighed for at sige nej, når en test ikke giver tilstrækkelig sikkerhed?
Svarene på de spørgsmål siger mere om ansvarlighed end et dramatisk citat alene. De kræver også mere dokumentation end et løfte om, at sikkerhed altid kommer først.
Hvad det har med Claude ChatGPT og kodeagenter at gøre
Arbejdsgang
Det I faktisk kan styre selv
Den globale debat løses ikke lokalt. Men rækkefølgen herunder afgør, hvad en AI-løsning i jeres egen virksomhed kan nå at gøre, før et menneske har set det.
- 01
Afgræns opgaven
Hvilke data og hvilke handlinger kræver opgaven faktisk? Meget arbejde kan udføres uden direkte adgang til kundedata.
- 02
Giv kun den nødvendige adgang
Læseadgang, hvor det rækker. Skriveadgang kun, hvor nogen har besluttet det, og med en grænse for hvor store ændringer der må laves.
- 03
Godkend før ændringen får virkning
MenneskeEt forslag kan gennemlæses. En udført handling i en annoncekonto eller et kundesystem kan ikke altid rulles tilbage.
- 04
Log hvad der skete
Hvilke filer blev berørt, hvilke ændringer blev udført, og hvad var resultatet? Uden log kan en fejl ikke undersøges bagefter.
- Beslutter adgang
- Ejer eller systemansvarlig, ikke leverandøren
- Godkender ændringer
- Et navngivet menneske, ikke en rolle uden ansigt
- Kan stoppe kørslen
- Skal være aftalt, før løsningen sættes i drift
For Manids' læsere bliver forbindelsen konkret, når AI går fra at levere forslag til at udføre handlinger. Et udkast til en annoncetekst kan gennemlæses. En agent med adgang til en annoncekonto kan potentielt ændre noget, før et menneske har set resultatet. Konsekvensen afhænger af, hvilke funktioner og rettigheder løsningen faktisk har fået.
Anthropic beskriver en nyttig teknisk skelnen: I faste arbejdsgange bestemmer kode rækkefølgen, mens en agent i højere grad selv vælger fremgangsmåde og værktøjer. Virksomheden fremhæver også test, afgrænsede miljøer og stopbetingelser ved brug af agenter. Anthropics forklaring af workflows og agenter.
Det er ikke et spring direkte fra en automatiseret marketingopgave til Hubingers katastrofescenarie. Det er en måde at forstå, hvorfor kontrol bliver et mere håndgribeligt spørgsmål, når software kan handle på vores vegne.
En rapport er noget andet end en budgetændring
Forestil dig en AI, der gennemgår et eksport af kampagnedata og foreslår at flytte budget. Hvis den kun kan læse filen, stopper dens handlemuligheder ved anbefalingen. Hvis den også har skriveadgang til annonceplatformen, opstår et andet spørgsmål: Hvem har besluttet, hvilke ændringer den må udføre, og hvor store de må være?
Det er et tænkt eksempel. Pointen er, at produktnavnet ikke fortæller hele historien. Den samme model kan indgå i løsninger med meget forskellige konsekvenser, fordi adgangen omkring den er forskellig.
Et kodeforslag er noget andet end en ændring i drift
En kodeagent kan foreslå en rettelse, ændre filer og køre test i et udviklingsmiljø. Derfra er der stadig en beslutning om, hvad der kommer ud på en rigtig hjemmeside eller ind i et system med rigtige data.
Et nyttigt kontrolpunkt er derfor selve ændringen: Hvilke filer blev berørt? Hvad blev faktisk testet? Hvilke antagelser står stadig åbne? Et velformuleret svar fra agenten kan hjælpe med overblikket, men bør ikke stå alene som dokumentation for, at ændringen virker.
Vi behandler de konkrete anvendelser separat i artiklen om GPT-6 Astra og Codex i virksomheder. Her er spørgsmålet, hvordan ansvaret følger med, når værktøjerne får større handlemuligheder.
Kundedata gør afgrænsningen vigtigere
En assistent, som skriver et svarudkast ud fra en godkendt produktbeskrivelse, har en afgrænset opgave. En løsning, som selv slår personer op, kombinerer oplysninger og sender beskeder, kræver flere bevidste valg om adgang og godkendelse.
Det praktiske spørgsmål er, om systemet har mere råderum, end opgaven kræver. Kan en del af arbejdet udføres uden direkte adgang til kundedata? Kan et forslag godkendes, før det sendes? Kan man se, hvad der faktisk skete, hvis resultatet bliver forkert?
Den samme afvejning findes den anden vej: hvilke AI-tjenester skal overhovedet have adgang til jeres offentlige indhold? Det behandler vi i artiklen om Cloudflare og AI-bots.
De spørgsmål giver mening, selv hvis man er dybt uenig i advarslen om menneskehedens udryddelse. Man behøver ikke acceptere ét bestemt fremtidsscenarie for at tage ansvar for en konkret integration.
Samtidig skal skalaen holdes ærlig. Adgangsstyring i en dansk virksomhed løser ikke det globale alignmentproblem. Den hjælper virksomheden med at styre sin egen anvendelse. Den bredere debat handler også om forskning, samfundets beslutninger og kontrollen med systemer, som den enkelte bruger ikke selv udvikler.
Hvad skal der til for at blive klogere
Den næste vigtige nyhed behøver ikke være et endnu højere risikotal. Den kan være mere konkret dokumentation, som ændrer grundlaget for vurderingerne.
Det kan være en uafhængig undersøgelse, der viser, hvilke evner et system faktisk har under realistiske betingelser. Det kan være en offentlig beskrivelse af, hvordan en sikkerhedsforanstaltning blev afprøvet, og hvor den svigtede. Eller en tydelig forklaring af, hvilke krav en virksomhed stiller, før den giver et system mere autonomi.
For en kritisk læser er fem spørgsmål særligt nyttige:
-
Hvem fremsætter påstanden? En medarbejder, en forskergruppe, virksomheden eller en uafhængig evaluator?
-
Hvad handler den om? Nuværende modeller, en bestemt anvendelse eller fremtidige systemer?
-
Hvilken type grundlag er der? Målinger, forsøg, observerede hændelser, scenarier eller et personligt skøn?
-
Hvilke betingelser gælder? Hvad kunne systemet tilgå, hvor længe kørte det, og hvem kunne gribe ind?
-
Hvad ville ændre vurderingen? En stærk forklaring bør gøre det muligt at forstå, hvilken ny viden der tæller for eller imod den.
Den tilgang fjerner ikke usikkerheden. Den gør det lettere at opdage, når en overskrift giver indtryk af mere sikker viden, end kilden faktisk indeholder.
Det centrale er hvem der har kontrollen
Der er ikke fremlagt et fælles videnskabeligt facit i de opslag, denne artikel gennemgår. Der er fremlagt alvorlige advarsler fra mennesker tæt på udviklingen, og der er rejst væsentlige indvendinger mod både sandsynlighedstallene og fortællingen om, hvor teknologien er på vej hen.
Manids' vurdering er, at historien fortjener opmærksomhed, fordi den handler om mere end endnu en model, der scorer bedre i en test. Den rejser spørgsmålet om, hvordan stadig mere kapabel software får adgang til at påvirke verden, og hvem der kan kontrollere beslutningerne undervejs.
Det er muligt at bruge AI med stor nytte og samtidig kræve bedre dokumentation fra virksomhederne bag. Det er muligt at være skeptisk over for en dommedagsprognose og samtidig kritisk over for et udviklingskapløb uden tilstrækkeligt indblik udefra.
Det præcise budskab fra Hubingers opslag er derfor værd at fastholde: En navngiven forsker vurderer personligt en bestemt fremtidig risiko til over 10 procent. Han afgrænser selv advarslen fra risikoen ved de nuværende modeller. Resten af debatten begynder dér, hvor vi undersøger, om hans antagelser holder.
Vil du forstå den daglige brug af teknologien, kan du fortsætte til Manids' guide til AI i marketing eller gennemgangen af Claude-modellerne.
Om kilderne: Artiklen bygger på offentlige udsagn, de gengivne screenshots og de linkede rapporter og kommentarer. Reaktionerne er udvalgt for at vise forskellige synspunkter og er ikke en repræsentativ forskerundersøgelse. Udtalelser fra medarbejdere gengives som personlige synspunkter, medmindre andet fremgår. Manids har ikke interviewet de citerede personer.
Kilder
20 kilder, som påstandene i artiklen bygger på. Kontrolleret 16. september 2026.
- 1.Coxons opslag
- 2.Hubingers svar
- 3.TechCrunchs dækning af sagen
- 4.Anthropics undersøgelse af agentic misalignment
- 5.Selsams redegørelse, 14. september
- 6.Risk Report, august 2026
- 7.Rapporten, side 97–101
- 8.Kilde og metode
- 9.Marks' opslag
- 10.Business Insiders gennemgang
- 11.Opslag
- 12.samlingen af reaktioner
- 13.Opslag
- 14.Korbaks opslag
- 15.Opslag
- 16.Opslag
- 17.Bentons egen begrundelse
- 18.Newports kommentar
- 19.The Guardians ekspertgennemgang, 15. september
- 20.Anthropics forklaring af workflows og agenter
Relaterede artikler
Alle artiklerChatGPT og OpenAI i 2026: hvor er de på vej hen?
Hvor bevæger ChatGPT og OpenAI sig hen i 2026? Fra chatbot til arbejdsplatform: modelportefølje, agenter, Codex og hvad det betyder for marketing.
Læs artiklenClaude Fable 5: hvad lanceringen betyder for din virksomhed
Claude Fable 5 er Anthropic-modellen til tunge opgaver. Se, hvad danske SMV'er bør teste, styre og undgå.
Læs artiklenClaude Fable 5 og Mythos 5 suspenderet: hvad virksomheder kan lære
Anthropic suspenderede kort adgang til Fable 5 og Mythos 5. Se hvad der skete, hvorfor det er en driftsrisiko, og hvordan I bygger en fallback.
Læs artiklen